
Uzun kontekst oʻzgarishlarni aniq kuzatishni kafolatlamaydi — buni StateBench koʻrsatdi
Tadqiqotchilar til modellari uzun hujjatlarda obyektlar holatidagi oʻzgarishlarni qanday kuzatishini baholash uchun StateBench nomli benchmarkni taqdim etdi.
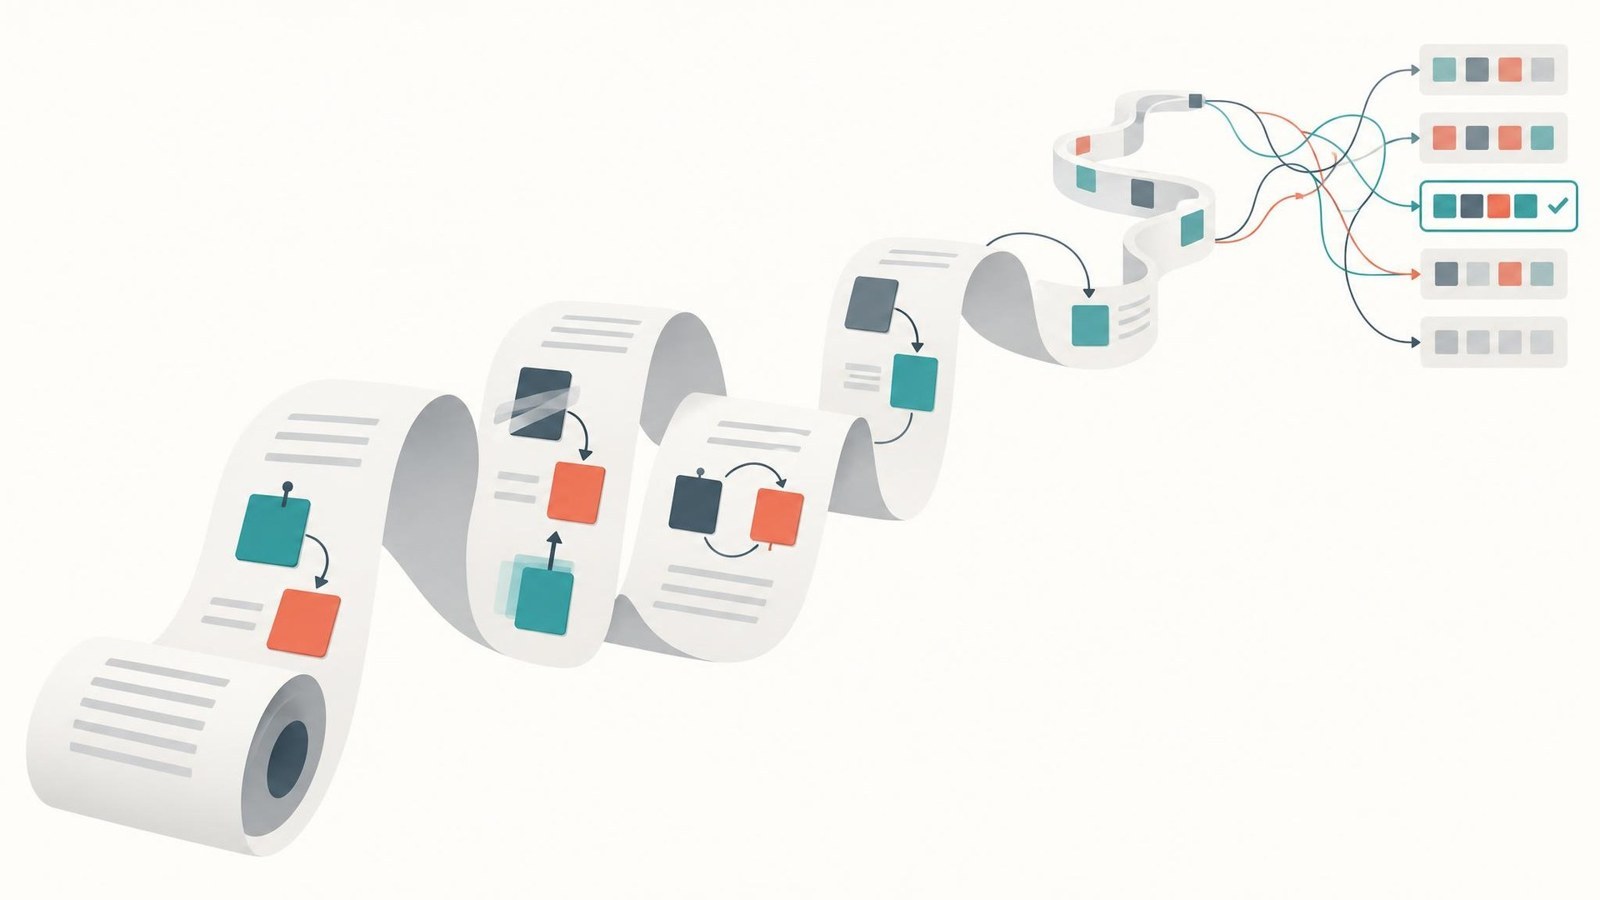
Tadqiqotchilar holatni kuzatishning toʻrt darajasini — dastlabki qiymatni topishdan tortib, oʻzaro bogʻliq oʻzgarishlar zanjirlarini hisobga olishgacha — baholash uchun StateBenchni ishlab chiqdi. Benchmark bir nechta formatdagi vazifalarni tekshiradi, bunda oʻzgarishlar kiritiladigan oʻzgaruvchilar, qiymatlar va pozitsiyalar soni bir xil saqlanadi.
Ochiq modellar sinovida deyarli barcha tizimlar oddiy vazifalarni yaxshi bajardi, biroq kirish hajmi oshgani sari davriy boʻlmagan vazifalarda aniqlikni yoʻqotdi va umumiy yakuniy holat turidagi vazifalarda tasodifiy taxmin darajasida qoldi. Gemini 3.8 Flash, Claude Opus 5.5 hamda GPT-6 Sol va Luna ikki asosiy darajada yaxshi natija koʻrsatdi, biroq murakkabroq vazifalarda eng uzun umumiy yakuniy holat turidagi topshiriqlarda aniqlik 13 foizgacha yoki undan ham pastga tushdi.
StateBenchning oʻzida bevosita oʻqitilganda, gibrid modellar va Gated DeltaNet uchta nisbatan sodda darajadagi natijalarni sinovdan oʻtkazilgan eng uzun ketma-ketliklargacha — oʻn minglab tayinlovlargacha — deyarli xatosiz umumlashtirdi. Transformerlar sodda darajalarni oʻzlashtirdi, ammo uzun ketma-ketliklarda natijalari yomonlashdi va umumiy yakuniy holat turidagi vazifalarni yechishni oʻrgana olmadi. Mualliflar taʼkidlashicha, test oʻzgaruvchilar soni qatʼiy belgilangan boʻlishini nazarda tutadi, real vazifalarda esa matn davomida yangi obyektlar paydo boʻlishi mumkin.
Yana oʻqing
Anthropicning yangi prototipi AI javoblarining haqiqiyligini tekshirishga yordam beradi
Tadqiqotlar11:42
Anthropic sunʼiy intellektning rekursiv oʻzini-oʻzi takomillashtirishiga yaqinlashayotgani haqida ogohlantirdi
Tadqiqotlar3-noyabr, 10:47