
Длинный контекст не гарантирует точного отслеживания изменений — показал StateBench
Исследователи представили StateBench — бенчмарк для оценки того, как языковые модели отслеживают изменения состояния сущностей в длинных документах.
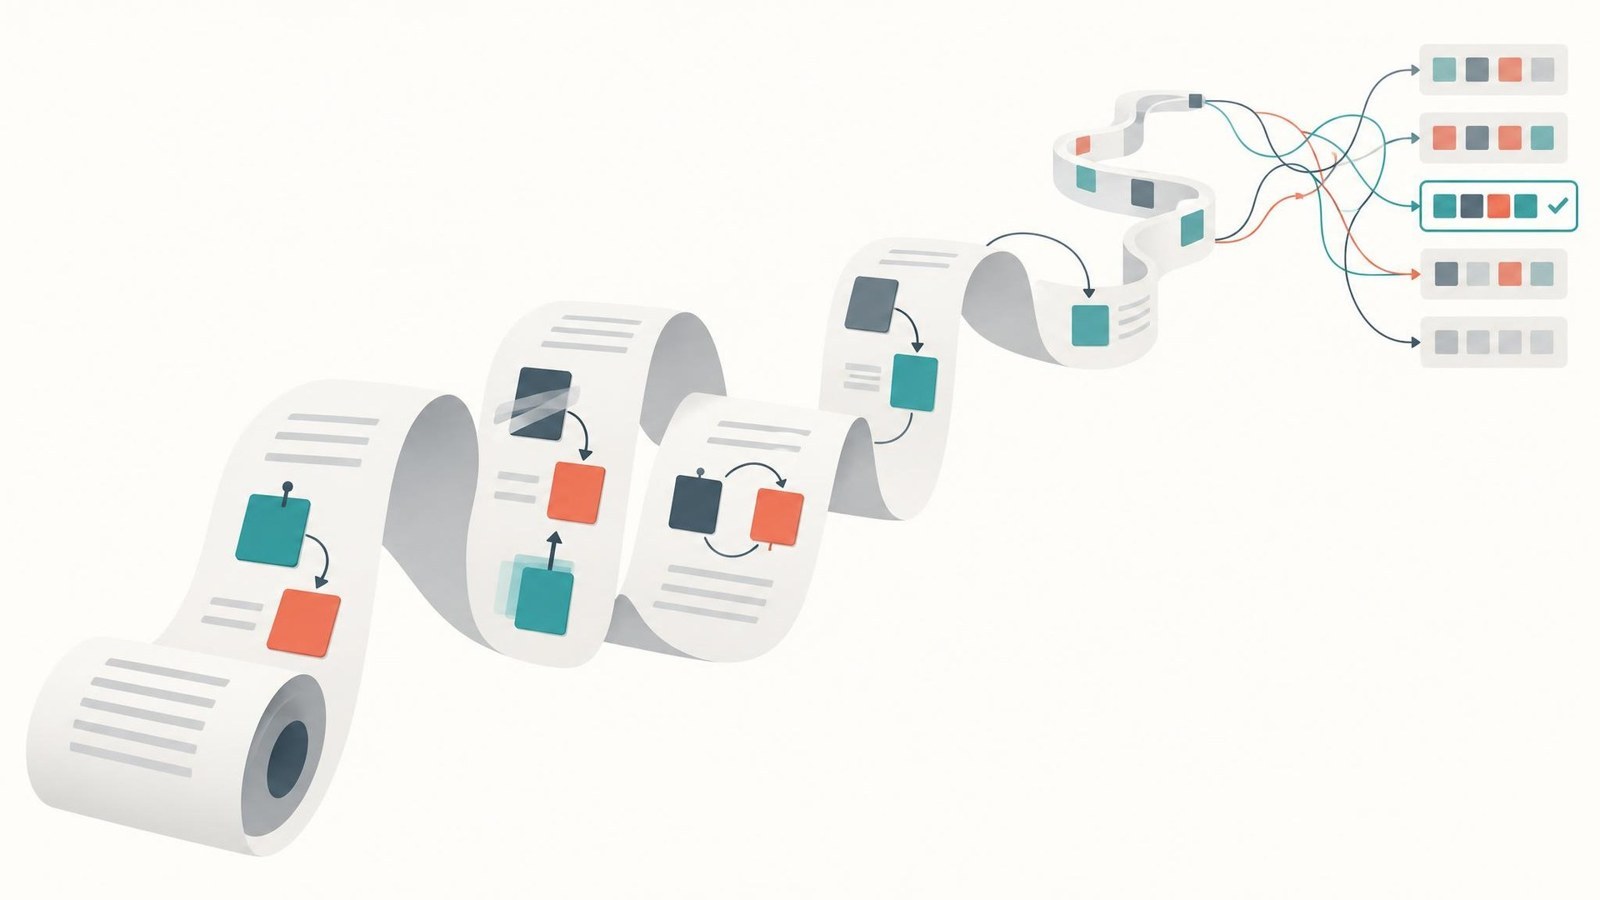
Исследователи разработали StateBench для оценки четырёх уровней отслеживания состояния — от поиска первоначального значения до учёта цепочек взаимосвязанных изменений. Бенчмарк проверяет задачи в нескольких форматах, сохраняя одинаковыми число переменных, значений и позиции обновлений.
На открытых моделях почти все системы хорошо справились с простыми заданиями, но теряли точность на апериодических задачах по мере роста длины входа и оставались на уровне случайного угадывания в задачах общего конечного типа. Gemini 3.8 Flash, Claude Opus 5.5 и GPT-6 Sol и Luna показали хорошие результаты на двух базовых уровнях, однако на более сложных точность на самых длинных задачах общего конечного типа упала до 13% или ниже.
При обучении непосредственно на StateBench гибридные модели и Gated DeltaNet почти безошибочно обобщали результаты на трёх более простых уровнях вплоть до самых длинных проверенных последовательностей — десятков тысяч назначений. Трансформеры освоили простые уровни, но ухудшали результаты на длинных последовательностях и не научились решать задачи общего конечного типа. Авторы отмечают, что тест предполагает фиксированное число переменных, тогда как в реальных задачах новые сущности могут появляться по ходу текста.